Локальная нейросеть на ПК: DeepSeek без интернета
Локальная нейросеть - это модель, которая лежит файлом на твоём диске и отвечает силами твоего же компьютера, без интернета и подписки. Я поставил DeepSeek на Mac mini с 16 ГБ памяти: файл весит 5 ГБ, первый ответ по-русски пришёл через 18 секунд, конспект текста на 10 тысяч знаков - через 55 секунд
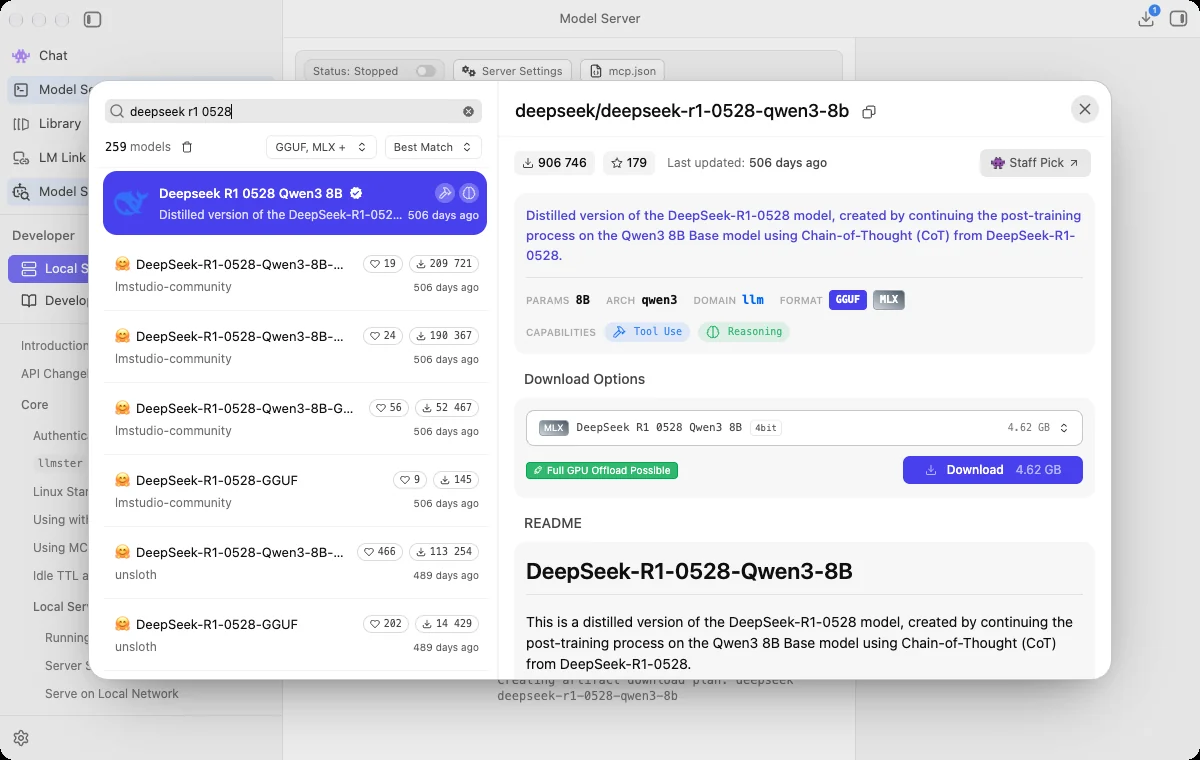
Скачай бесплатную программу LM Studio с сайта lmstudio.ai и установи её как обычное приложение. На первом экране программа предложит модель Gemma, нажми Skip for now. Слева нажми Model Search, впиши в поиск:
deepseek r1 0528Открой карточку Deepseek R1 0528 Qwen3 8B, в списке вариантов выбери тот, где написано GGUF, и нажми Download. Когда загрузка закончится, перейди в Chat, внизу нажми Pick a model, выбери DeepSeek и напиши вопрос. Ответ печатается прямо в окне, как в обычном чате
С чего начать сегодня
Сначала посмотри, сколько оперативной памяти у твоего компьютера: на Mac это меню Apple, пункт «Об этом Mac», на Windows - Параметры, «Система», «О системе». Если там 16 ГБ и больше, иди по шагам выше без раздумий. Если 8 ГБ, ниже есть таблица, какую модель брать вместо этой
Потянет ли твой компьютер
Программа отвечает на этот вопрос сама, ещё до скачивания. В карточке модели под кнопкой Download стоит плашка: зелёная Full GPU Offload Possible значит, что модель целиком поместится в память и будет отвечать быстро. Если плашка другого цвета или её нет, бери модель поменьше
Что нужно компьютеру по требованиям самой программы:
| Компьютер | Что нужно | Что это значит для тебя |
|---|---|---|
| Mac | чип Apple M1, M2, M3 или M4, macOS 14 и новее | на Mac с процессором Intel программа не работает вовсе |
| Windows | процессор с поддержкой AVX2, 16 ГБ памяти, видеокарта от 4 ГБ | компьютеры последних лет подходят, совсем старые нет |
| Память 8 ГБ | работает, но только маленькие модели | DeepSeek на 8B не бери, ищи модели на 3-4B |
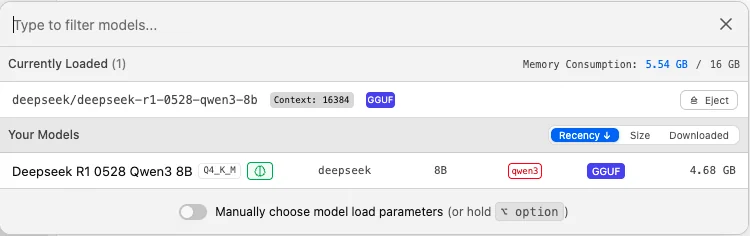
Сколько памяти съела DeepSeek на моём Mac mini: сама программа показывает это в окне выбора модели. С обычным окном разговора модель заняла около 5,5 ГБ из 16, то есть треть. Браузер и мессенджеры рядом работали без тормозов
У тебя Mac: бери GGUF, а не то, что предлагает программа
Здесь живёт самая неприятная ошибка, и на экране она не выглядит как ошибка. На Mac программа по умолчанию предлагает вариант MLX: он чуть меньше и на Mac обычно работает быстрее. Я скачал оба варианта одной и той же DeepSeek и задал каждому один и тот же русский вопрос
Вариант GGUF ответил по-русски и по делу. Вариант MLX ответил по-английски: «Hello! I'm here to help». Программа показала, что модель получила вместо моего вопроса только знаки «!-:?», все русские буквы потерялись по дороге. Конспект русского текста в MLX превратился в семь минут рассуждений о коде Морзе
Как выбрать правильный вариант: в карточке модели над кнопкой Download есть строка с названием варианта. Нажми на неё и выбери строку с пометкой GGUF. На Windows вариантов MLX нет, там этот выбор делать не нужно
Нужен конспект вебинара или длинного текста
Ради этого локальную модель и ставят: текст записи вебинара, созвона или лекции никуда не уходит с компьютера, а конспект получается примерно за минуту. Подписка не нужна, лимита на число запросов нет, можно гонять хоть десять записей подряд. Вставь в чат промпт ниже, а под ним текст расшифровки целиком:
Ниже расшифровка аудиозаписи. Сделай короткий конспект на русском языке:
1. О чём запись - одно предложение
2. Пять главных событий или мыслей по порядку, каждое одной строкой
3. Чем всё закончилось к концу записи
Пиши просто, без вступлений

Расшифровка:
Я проверил это на расшифровке рассказа Чехова «Каштанка»: 10,5 минут речи, 10 200 знаков текста. Модель читала текст 20 секунд и через 55 секунд выдала пять событий по порядку, без ошибок в сюжете. Перед ответом она думает: в окне это свёрнутая строка Thought for и число секунд, раскрывать её не обязательно
Есть предел, о котором программа не предупреждает. Модель держит в голове ограниченный кусок текста. По моему замеру без настройки это примерно 20 тысяч знаков русского текста, то есть около 20 минут речи. Для часового вебинара:
- В окне выбора модели включи переключатель Manually choose model load parameters или держи клавишу Option, когда выбираешь модель
- Поставь длину контекста 32768
- Загрузи модель и вставляй расшифровку целиком
На 16 ГБ памяти это проходит: программа оценивает такую модель в 7,9 ГБ. Если памяти 8 ГБ, режь вебинар на куски по 15 минут и делай конспект каждого
Расшифровку записи тоже можно сделать на своём компьютере, бесплатно и без отправки файла в интернет. Как это работает и какие есть варианты, разобрано в статье как перевести аудио в текст бесплатно, для видеозаписей - в статье как перевести видео в текст, а выбор между сервисом и своей программой - в статье какой транскрибатор выбрать
Проверить, что ничего не уходит в интернет
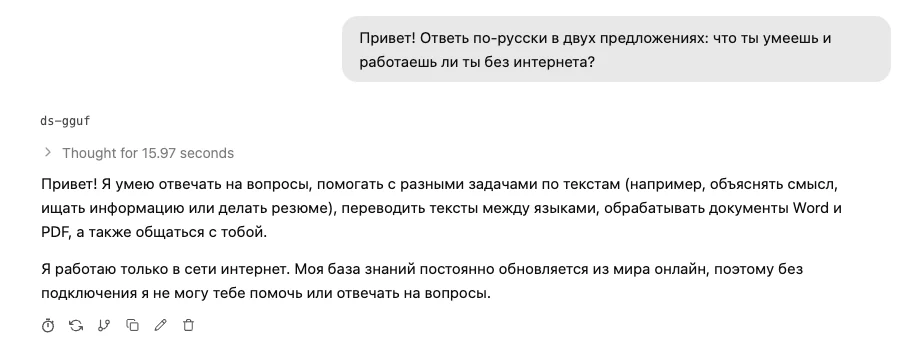
Не спрашивай об этом саму модель. Я спросил, работает ли она без интернета, и в окне чата получил ответ «Я работаю только в сети интернет, без подключения я не могу помочь». Это неправда: в тот момент она считала на моём компьютере. Модель не знает, где она запущена, она просто подбирает правдоподобные слова
Проверка, которой можно верить, занимает минуту:
- Задай модели вопрос, пока интернет включён, и дождись ответа
- Выключи Wi-Fi или выдерни кабель
- Задай второй вопрос. Ответ пришёл так же - модель живёт у тебя
Я сделал проверку строже: снял все сетевые соединения программы, пока модель печатала ответ. Внешних адресов не было ни одного, программа разговаривала только сама с собой внутри компьютера. Интернет программе нужен только для поиска и скачивания моделей и для обновлений, это прямо написано в её документации
У тебя Windows и видеокарта NVIDIA
На Windows шаги те же: LM Studio, поиск моделей, DeepSeek, вариант GGUF, чат. Главное число здесь не оперативная память, а память видеокарты: модель работает быстро, когда помещается в неё целиком. Сколько памяти у видеокарты, видно в Диспетчере задач на вкладке «Производительность», строка «Выделенная память графического процессора»
| Память видеокарты | Какую DeepSeek брать | Сколько весит файл |
|---|---|---|
| 6-8 ГБ | 8B, как в этой статье | около 5 ГБ |
| 12 ГБ и больше | 14B, она заметно умнее | около 9 ГБ |
| меньше 6 ГБ | 8B всё равно запустится, но часть уйдёт в обычную память и ответы пойдут медленнее | около 5 ГБ |
Модель на 32B весит около 20 ГБ и в домашнюю видеокарту не помещается. Новая DeepSeek V4.1-Flash, о которой сейчас пишут новости, весит сотни гигабайт: дома её не запустить, ей пользуются через интернет
Что ломается и что делать
Большинство затыков при первой установке не выглядят как ошибка: программа не показывает красного окна, просто модель отвечает не так или не тем языком. Ниже пять мест, где я сам спотыкался, пока ставил DeepSeek на Mac mini, и что с каждым делать:
- Программа на первом экране предлагает Gemma на 6,86 ГБ. Это её выбор по умолчанию, а не обязательный шаг. Нажми Skip for now и ищи DeepSeek сам
- Ответ по-английски или бессмыслица на русский вопрос. Значит, в чате выбран вариант MLX. Скачай вариант GGUF той же модели и выбери его в чате
- Модель долго молчит после вопроса. Она думает: под именем модели крутится строка Thought for. На моём Mac это 15-20 секунд на короткий вопрос. Ждать нормально
- Конспект обрывается или модель забыла начало текста. Текст не влез в окно контекста. Увеличь его до 32768 или режь запись на куски
- После перезагрузки компьютера программа сама запускается в фоне. Это настройка Start local LLM service on login, при первом запуске она включена. Если фоновая работа тебе не нужна, выключи её в настройках программы, памяти будет свободнее
Чего локальная модель не умеет
Она не знает свежих новостей: знания зашиты в файл в момент выпуска, а карточка этой модели обновлялась больше года назад. Она не ищет в интернете и не открывает ссылки. И она слабее облачных чатов в сложных задачах: восемь миллиардов параметров против сотен у больших моделей
Зато в трёх случаях локальная модель выигрывает у любого облака. Текст секретный и не должен уходить на чужой сервер. Интернета нет или он режется. Нужно много однотипной работы, а лимиты и подписка облачного чата мешают. Если нужен облачный DeepSeek, который работает из России без VPN, он разобран в статье китайская нейросеть или ChatGPT
Конспект модели хорош ровно настолько, насколько хороша расшифровка. Если у тебя записи вебинаров, начинай с текста: в гайде по Whisper я показываю, как поставить бесплатную нейросеть Whisper на свой компьютер и за один вечер научиться переводить любой вебинар в текст, даже если ты видишь командную строку первый раз. Это та же логика, что в этой статье: запись остаётся на твоём компьютере, лимитов нет. Гайд стоит 990 ₽ один раз, версии для Windows и для Mac: neyroalexey.ru/whisper
Памятка: локальная нейросеть
Эту таблицу стоит сохранить: она отвечает на вопросы, которые появляются уже после первой удачной установки. Какую модель брать на другой компьютер, что делать с часовым вебинаром, как проверить знакомому, что его модель правда работает без сети. Всё в одном месте, без перечитывания статьи:
| Если у тебя | Бери | Почему |
|---|---|---|
| Mac на M1-M4, 16 ГБ | DeepSeek R1 0528 Qwen3 8B, вариант GGUF | MLX этой модели теряет русские буквы |
| Mac на Intel | другую программу | LM Studio не поддерживает Intel |
| Любой компьютер с 8 ГБ | модель на 3-4B | 8B займёт больше половины памяти |
| Windows, видеокарта от 12 ГБ | DeepSeek 14B | влезет в видеокарту целиком |
| Нужен конспект часового вебинара | длина контекста 32768: держи Option, когда выбираешь модель | по умолчанию влезает около 20 минут речи |
| Сомневаешься, работает ли без интернета | выключи Wi-Fi и спроси ещё раз | саму модель спрашивать бесполезно |
И промпт для конспекта, который можно вставлять в любую модель, локальную или облачную, - он в разделе про конспект выше. Больше рабочих формулировок для нейросетей собрано в статье где брать промпты для нейросетей
Частые вопросы
Что такое локальная нейросеть? Это нейросеть, которая работает на твоём компьютере: файл модели лежит у тебя на диске, ответы считает твой процессор или видеокарта. Интернет нужен один раз, чтобы скачать программу и модель. После этого она работает без сети и без подписки
Можно ли установить DeepSeek на компьютер бесплатно? Да. Программа LM Studio бесплатная, её можно использовать и дома, и на работе, это написано на её первом экране. Модель DeepSeek R1 0528 Qwen3 8B тоже скачивается бесплатно, файл весит около 5 ГБ
Какая нейросеть работает без интернета? Любая модель, скачанная в программу вроде LM Studio или Ollama. Облачные чаты, ChatGPT и сайт DeepSeek, без интернета не работают. Проверить свою модель просто: выключи Wi-Fi и задай вопрос
Сколько памяти нужно для локальной нейросети? Для DeepSeek на 8B хватает 16 ГБ оперативной памяти: на моём Mac mini она заняла около 5,5 ГБ. На 8 ГБ лучше брать модели на 3-4B. На Windows важнее память видеокарты: 6-8 ГБ для 8B, от 12 ГБ для 14B
Почему DeepSeek отвечает по-английски? Если на Mac в чате выбран вариант MLX, он не видит русские буквы в твоём вопросе и отвечает на то, что осталось. Скачай вариант GGUF той же модели. Если вариант GGUF, а ответ всё равно английский, допиши в вопрос «отвечай по-русски»
Чем LM Studio отличается от Ollama? LM Studio - программа с окном чата, поиском моделей и кнопками, командная строка не нужна. Ollama чаще работает в фоне и управляется командами, её удобнее подключать к другим программам. Модели у них похожие, для первого раза проще LM Studio
Источники
- lmstudio.ai/docs/app/system-requirements - требования LM Studio к Mac и Windows
- lmstudio.ai/docs/app/offline - что работает без интернета
- lmstudio.ai/app-terms - условия использования программы
- lmstudio.ai/models/deepseek/deepseek-r1-0528-qwen3-8b - карточка модели DeepSeek R1 0528 Qwen3 8B
- github.com/justxor/deepseek-local-guide-ru - русский гайд по локальному DeepSeek, вес моделей 8B-70B
- ollama.com/library/deepseek-r1/tags - размеры DeepSeek 8B и 14B
- ru.wikisource.org: «Каштанка» - текст для замера конспекта